Moyenne contre médiane
Un seul géant suffit à déplacer la moyenneLa moyenne additionne tout et divise ; la médiane coupe la population en deux moitiés égales. Tant que les valeurs se ressemblent, les deux se confondent. Dès qu’une valeur extrême arrive, elles divergent. C’est pour cela que l’Insee publie les deux : dans le secteur privé en 2022, le salaire net moyen tourne autour de 2 600 € par mois, le salaire médian autour de 2 100 €. Fais entrer quelqu’un dans la boutique Kumo du Marais.
Twitter : l’utilisateur moyen n’existe pas
En 2019, le Pew Research Center analyse un échantillon de comptes Twitter d’adultes américains. Résultat : les 10 % les plus actifs produisent 80 % des tweets. L’utilisateur médian, lui, publie environ deux tweets par mois. Un « nombre moyen de tweets par utilisateur » décrirait quelqu’un qui ne ressemble ni aux uns ni aux autres.
À retenir : quand une minorité pèse très lourd, la moyenne décrit une personne qui n’existe pas. La médiane et la répartition disent la réalité.
Source : Pew Research Center, « Sizing Up Twitter Users », avril 2019.
Lire un salaire « moyen ». Dans une start-up dont le fondateur se paie très bien, le salaire moyen flatte l’entreprise. Demande la médiane.
Panier moyen. Quelques grosses commandes B2B gonflent le panier moyen d’un site. Regarde la médiane et la distribution avant de fixer un seuil de livraison gratuite.
L’échantillon
Mieux vaut 1 000 personnes tirées au hasard qu’un million mal choisiesEn 1936, le magazine Literary Digest reçoit 2,4 millions de réponses et annonce la défaite de Roosevelt. Roosevelt l’emporte avec 61 % des voix. Les questionnaires étaient partis vers des abonnés et des propriétaires de voitures et de téléphones, et seuls les plus motivés avaient répondu. George Gallup, avec un échantillon bien plus petit mais construit, donne le bon vainqueur. Kumo veut connaître la satisfaction de ses 20 000 clients.
Les sondages britanniques ratent l’élection
En mai 2015, les sondages annoncent un coude-à-coude entre conservateurs et travaillistes au Royaume-Uni. Les conservateurs gagnent avec plus de six points d’avance et une majorité absolue. L’enquête indépendante commandée par la profession conclut que la cause principale n’était ni la taille des échantillons ni le calcul, mais des échantillons non représentatifs : ceux qu’on joignait facilement ne votaient pas comme les autres.
À retenir : un échantillon plus grand ne corrige pas un échantillon mal tiré.
Source : Patrick Sturgis et coll., Report of the Inquiry into the 2015 British General Election Opinion Polls, British Polling Council et Market Research Society, 2016.
La taille réduit le hasard, pas le biais. Un échantillon mal tiré se trompe avec beaucoup d’assurance, et d’autant plus qu’il est gros.
Les avis en ligne. Ils viennent des très contents et des très mécontents. Utiles pour comprendre, trompeurs pour mesurer.
La marge d’erreur
Un écart plus petit que le bruit n’est pas un écartTout chiffre tiré d’un échantillon flotte. Pour un sondage de n personnes, la marge d’erreur vaut environ 1 ÷ √n : ±3 points pour 1 000 personnes, ±10 points pour 100. Deux scores dont les marges se chevauchent ne sont pas vraiment différents. Kumo teste deux versions de sa page produit : A convertit 3,0 % des visiteurs, B 3,6 %. B est-elle meilleure ?
Les 41 bleus de Google
En 2009, Douglas Bowman quitte son poste de responsable du design visuel chez Google. Dans son billet de départ, il raconte qu’une équipe a testé 41 nuances de bleu pour choisir la couleur d’un lien. Avec des centaines de millions de recherches par jour, Google peut détecter des écarts minuscules ; un dirigeant de Google au Royaume-Uni évoquera ensuite 200 millions de dollars de revenus supplémentaires.
À retenir : la taille de l’échantillon fixe le plus petit écart qu’on peut voir. Un petit site ne pourra jamais trancher entre deux bleus.
Source : Douglas Bowman, « Goodbye, Google », billet du 20 mars 2009 ; The Guardian, février 2014.
Fixer la taille avant. On décide de la durée du test avant de le lancer. Arrêter dès que B passe devant revient à choisir le hasard qui nous arrange.
Les petits effets coûtent cher. Diviser l’écart à détecter par deux demande quatre fois plus de visiteurs. Un petit site ne peut tester que de gros changements.
Le biais du survivant
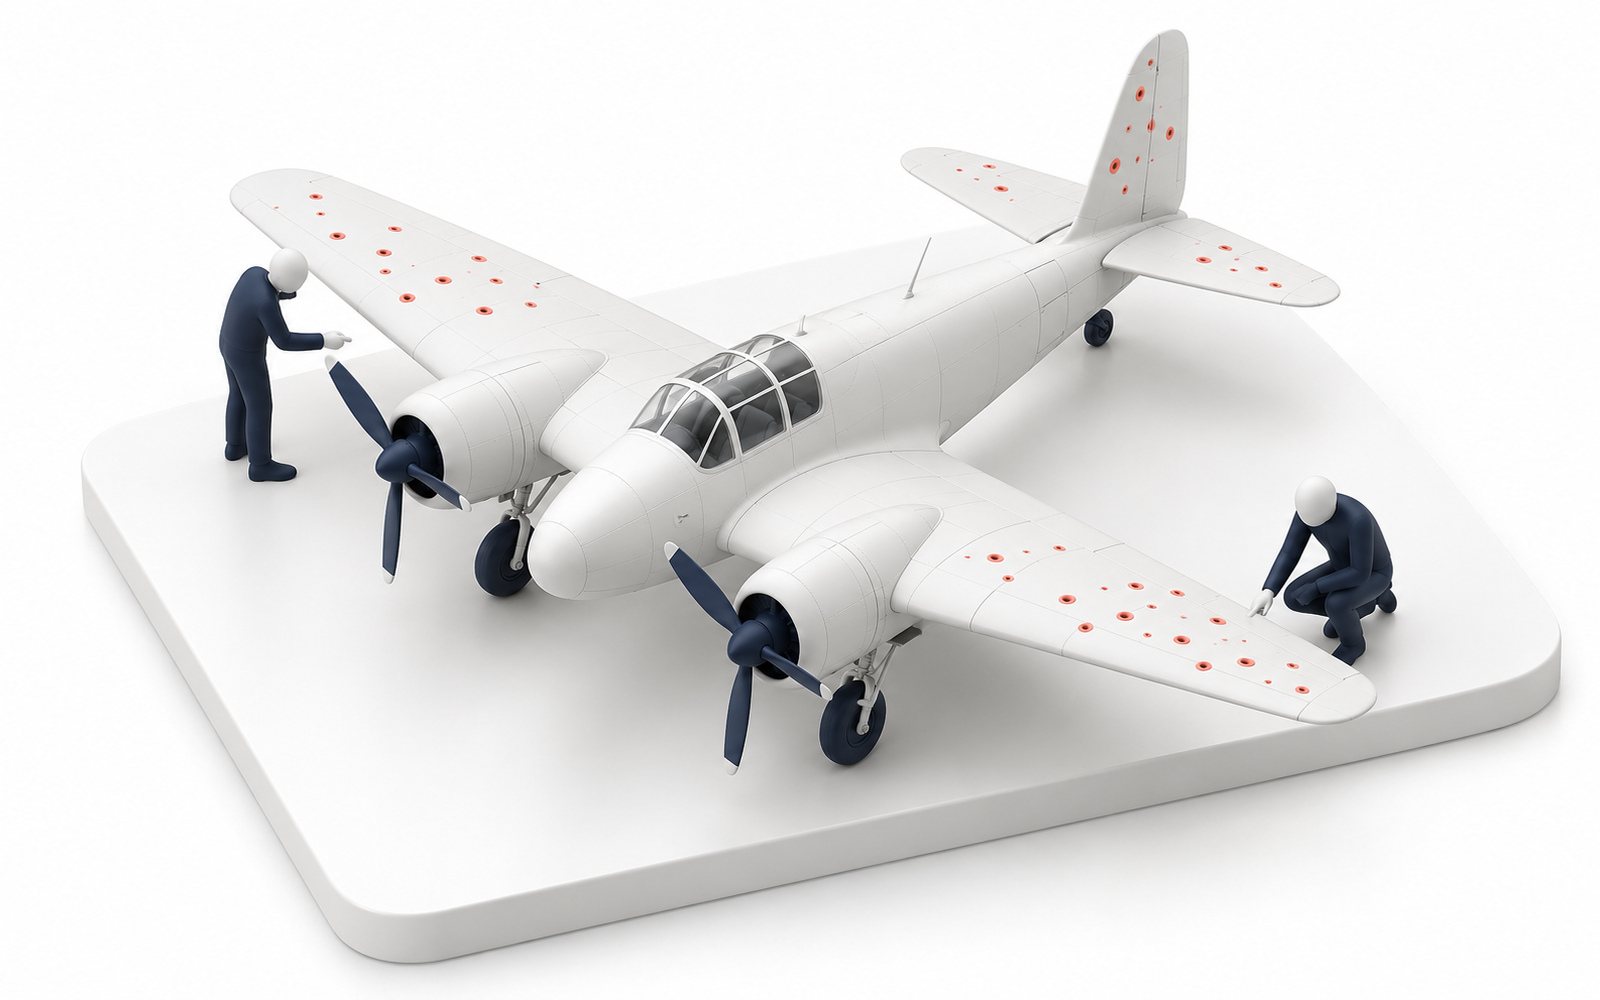
Les données ne montrent que ceux qui sont revenusEn 1943, le statisticien Abraham Wald travaille pour l’armée américaine au sein du Statistical Research Group de l’université Columbia. On relève les impacts sur les bombardiers qui rentrent de mission : ils sont nombreux sur les ailes et le fuselage, rares sur les moteurs. Où ajouter du blindage, qui alourdit l’avion ? L’intuition dit : là où il y a des trous. Wald dit l’inverse.
Les « grandes » entreprises qui ne le sont pas restées
En 2001, Jim Collins publie Good to Great, qui étudie onze entreprises passées d’une performance moyenne à une performance remarquable, pour en tirer des principes. Quelques années plus tard, Circuit City fait faillite et Fannie Mae est placée sous la tutelle de l’État américain en 2008. Partir des gagnants pour trouver la recette, c’est ignorer ceux qui avaient les mêmes traits et ont échoué.
À retenir : avant de copier les recettes d’un succès, demande où sont ceux qui ont fait pareil et ont disparu.
Source : Jim Collins, Good to Great, 2001 ; Phil Rosenzweig, The Halo Effect, 2007.
Les recettes du succès. Les livres sur les entreprises qui ont réussi oublient celles qui ont fait pareil et ont disparu. Leur « recette » n’est peut-être que de la chance.
Les clients qui restent. Une enquête auprès des clients actuels ne dit rien de ceux qui sont partis. Interroge aussi les clients perdus.
Corrélation n’est pas causalité
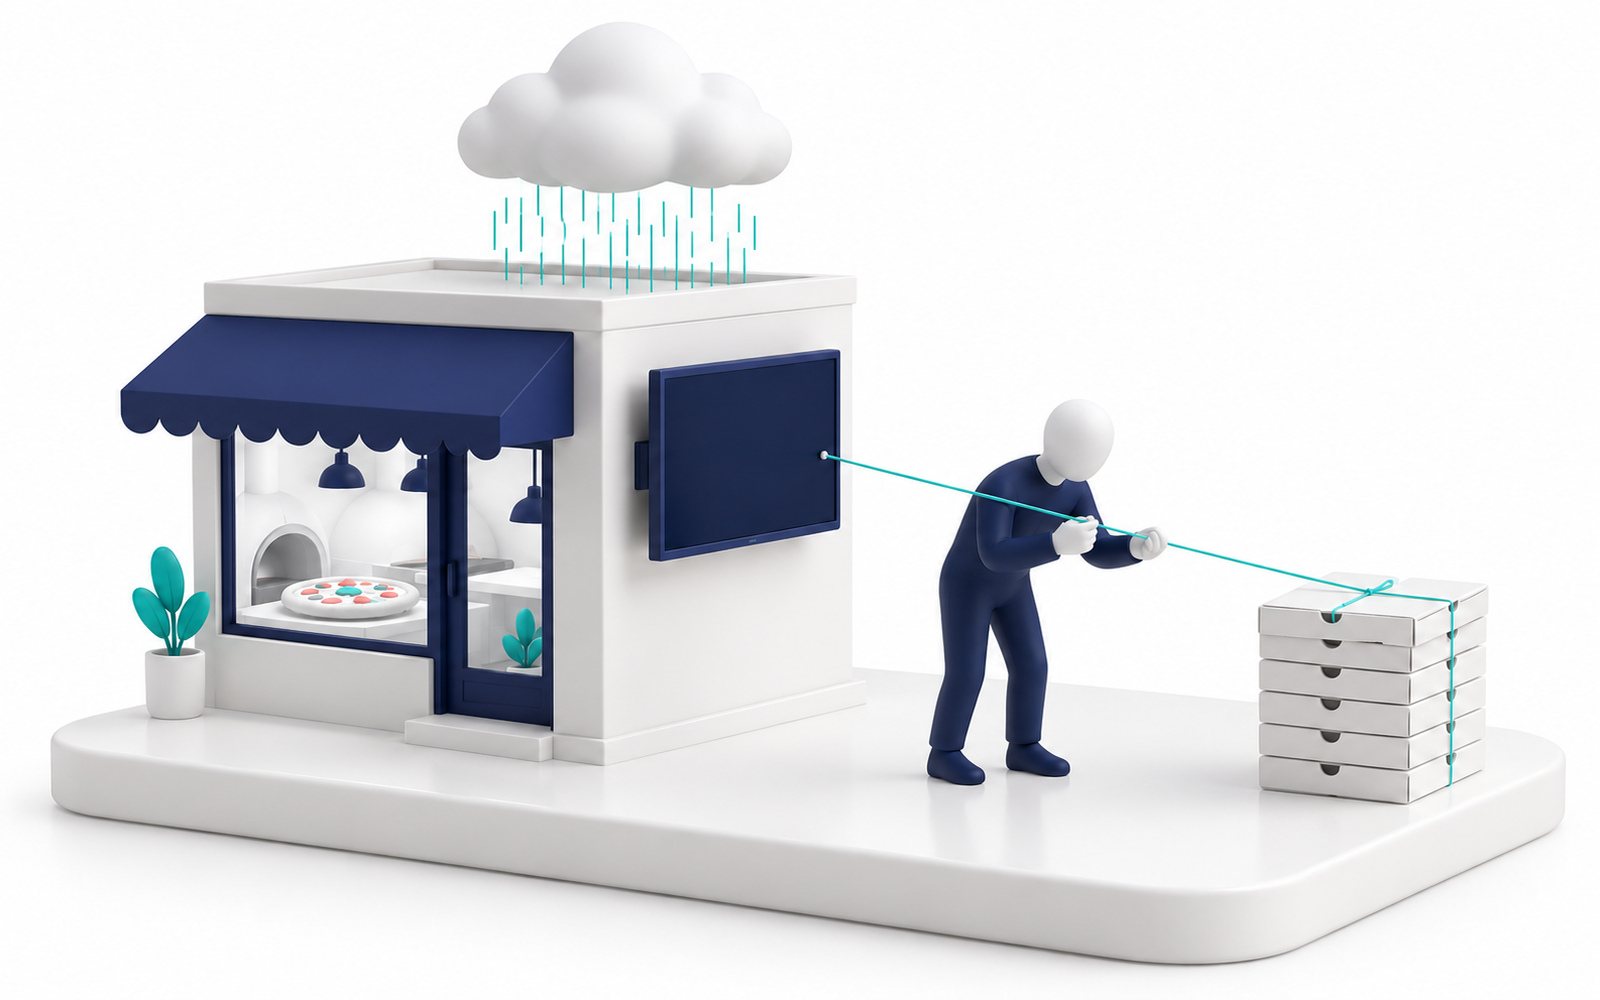
Deux choses qui bougent ensemble ont parfois une même cause cachéeLe patron d’une pizzeria passe un spot sur une télé locale certaines semaines. Les semaines avec spot, il livre nettement plus de pizzas. Il veut doubler le budget. Mais il a surtout diffusé son spot en novembre, les semaines où il pleuvait. Or quand il pleut, on se fait livrer. Un facteur caché peut produire une corrélation sans aucun lien de cause à effet.
Le traitement hormonal qui devait protéger le cœur
Pendant des années, des études d’observation montrent que les femmes ménopausées qui prennent un traitement hormonal font moins d’infarctus. Mais ces femmes sont en moyenne plus aisées et en meilleure santé. En 2002, un grand essai tiré au sort, la Women’s Health Initiative, est arrêté plus tôt que prévu : le traitement n’y protège pas le cœur et augmente certains risques.
À retenir : une corrélation, même répétée dans plusieurs études, ne vaut pas une expérience tirée au hasard.
Source : Writing Group for the Women’s Health Initiative Investigators, JAMA, juillet 2002.
Les trois questions. Devant une corrélation : est-ce le hasard ? Une cause commune ? Ou la causalité à l’envers (on fait de la pub parce que les ventes montent) ?
Le seul vrai juge. L’expérience tirée au hasard : test A/B, zones tests contre zones témoins, campagne coupée dans une région sur deux.
Médiane
Demander la médiane dès qu’un chiffre moyen est cité.
Échantillon et marge
Qui a répondu, combien, et quelle marge : 1 ÷ √n.
Survivants
Chercher ceux qui manquent aux données.
Causalité
Une corrélation se vérifie par une expérience tirée au hasard.
Le vérificateur de chiffres
Atelier Avant de croire un sondage ou un test A/BÀ toi. Saisis un chiffre qu’on te présente en réunion : un taux de satisfaction, une enquête, un test entre deux versions. Indique la taille de l’échantillon et qui a répondu. L’outil calcule la marge d’erreur, dit si l’écart entre deux groupes dépasse le bruit et combien de réponses il faudrait pour trancher. Tout est sauvegardé dans ton navigateur.
Ta synthèse
Saisis au moins un effectif et un taux.
Pour aller plus loin
- Insee, « Salaires dans le secteur privé en 2022 », Insee Première no 1971, novembre 2023.
- Peverill Squire, « Why the 1936 Literary Digest Poll Failed », Public Opinion Quarterly, 1988.
- Ron Kohavi, Diane Tang, Ya Xu, Trustworthy Online Controlled Experiments, Cambridge University Press, 2020.
- Abraham Wald, A Method of Estimating Plane Vulnerability Based on Damage of Survivors, Statistical Research Group, Columbia University, 1943 (réédité par le Center for Naval Analyses en 1980).
- Judea Pearl, Dana Mackenzie, The Book of Why, 2018 ; Darrell Huff, How to Lie with Statistics, 1954.
- Pew Research Center, « Sizing Up Twitter Users », 2019.
- Patrick Sturgis et coll., Report of the Inquiry into the 2015 British General Election Opinion Polls, 2016.
- Jim Collins, Good to Great, 2001 ; Phil Rosenzweig, The Halo Effect, 2007.
- Writing Group for the Women’s Health Initiative Investigators, « Risks and Benefits of Estrogen Plus Progestin in Healthy Postmenopausal Women », JAMA, 2002.